Gestionar un catálogo de moda con tres colecciones activas: los desafíos que solo se entienden desde adentro
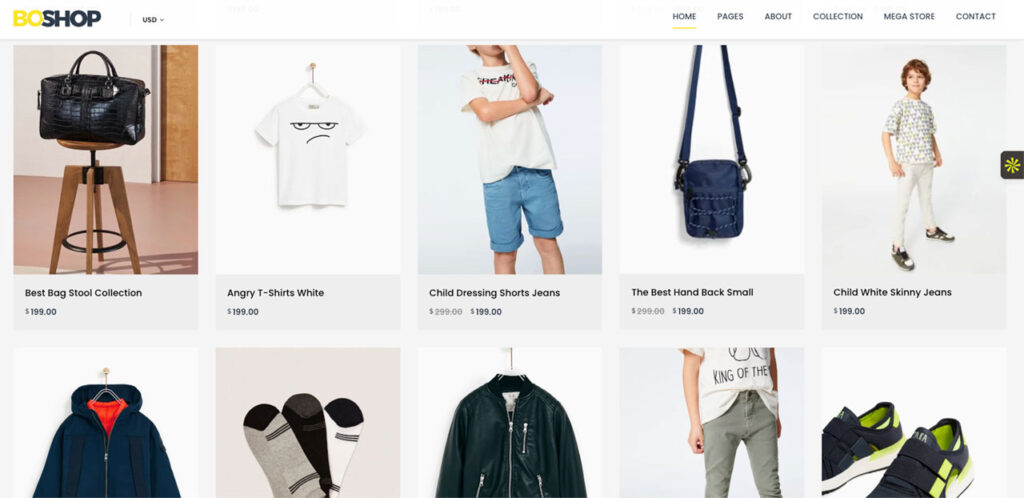
La estacionalidad, las variantes y la velocidad de rotación hacen del catálogo de moda uno de los más exigentes. Hoy les comparto mis aprendizajes de proyectos reales en el sector.
Hay algo que aprendí bastante rápido trabajando con información de producto: un catálogo de moda nunca está realmente terminado. En otros sectores, uno puede imaginar —aunque sea por un momento— que existe un punto en el que el catálogo queda ordenado, publicado y relativamente estable. En moda, esa sensación dura poco.
Gestionar un catálogo de moda con varias colecciones activas al mismo tiempo exige bastante más que cargar productos nuevos cada temporada. Hay que poder administrar distintos momentos del ciclo de vida del dato, matrices de variantes, talles y colores normalizados, activos visuales, estados de publicación y requisitos específicos por canal sin reconstruir el catálogo cada vez que cambia la colección.
Eso es lo que vuelve especialmente exigente a este tipo de proyectos.
Mientras una colección está plenamente a la venta, otra empieza a cargarse y enriquecerse, y una anterior puede seguir publicada porque todavía tiene stock, promociones o productos en liquidación. Al mismo tiempo llegan nuevos colores, cambian imágenes, aparecen variantes que faltaban y algún canal exige información que hasta ese momento no era necesaria.
Y la próxima temporada ya está esperando su turno.
Por eso, cuando pienso en tres colecciones activas, no pienso simplemente en tres grupos de productos. Pienso en tres momentos diferentes del ciclo de vida del dato conviviendo dentro del mismo sistema.
Ese es, para mí, el verdadero desafío.
Akeneo describe algo muy parecido cuando analiza la gestión de los cambios estacionales: incorporar nuevos productos, actualizar cientos o miles de SKUs, agregar imágenes y distribuir todo a distintos canales convierte cada cambio de temporada en una operación considerable. Desde adentro, esa operación tiene algunas particularidades que vale la pena mirar con lupa.
En moda, tres colecciones activas no son tres catálogos separados: son tres momentos del ciclo de vida del dato que el mismo modelo debe poder sostener.
Tres colecciones no son tres catálogos separados
Imaginemos una situación bastante habitual.
Tenemos una colección actual completamente publicada. Los productos están disponibles en el eCommerce, algunos también se distribuyen a marketplaces y las tiendas físicas necesitan disponer de su información.
En paralelo, la próxima colección está ingresando al PIM. Los productos existen, pero muchos todavía están incompletos: falta una composición, algunas fotografías no llegaron, marketing sigue trabajando las descripciones y quedan equivalencias de talles por revisar.
Mientras tanto, la colección anterior no puede desaparecer. Parte del stock todavía está disponible y determinados artículos continúan vendiéndose.
Eso significa que dentro del catálogo conviven productos en estados muy diferentes:
- productos activos y publicados;
- productos nuevos en proceso de enriquecimiento;
- variantes todavía incompletas;
- productos con información aprobada pero aún no habilitados para determinados canales;
- productos discontinuados que siguen teniendo stock;
- referencias que deben dejar de publicarse sin desaparecer del histórico.
El problema aparece cuando estas diferencias no están modeladas.
Si el único estado disponible es activo/inactivo, tarde o temprano alguien termina creando una planilla paralela para explicar qué significa realmente cada producto. Después aparece otra para controlar fotografías. Otra para los lanzamientos. Otra para registrar qué variantes faltan.
Mi objetivo es que el propio catálogo pueda responder preguntas concretas: ¿a qué colección pertenece este producto?, ¿en qué etapa está?, ¿está listo para publicar?, ¿en qué mercado?, ¿en qué canal?, ¿qué información le falta?
Parece mucha estructura alrededor de una prenda. Pero es precisamente esa estructura la que evita tener que reconstruir la historia del producto cada vez que cambia la temporada.
¿Cómo se complica el catálogo cuando aparecen las variantes?
Las variantes son uno de los puntos donde la complejidad de moda crece más rápido.
Pensemos en una camisa disponible en cuatro colores y cinco talles. Comercialmente podemos hablar de un solo modelo, pero operativamente aparecen veinte combinaciones posibles y, potencialmente, veinte SKUs.
Ahí surge una de las decisiones más importantes del modelado: qué información pertenece al producto padre y cuál corresponde realmente a cada variante.
La marca, el nombre del modelo, la colección o una composición compartida pueden vivir en un nivel superior. El talle pertenece a la variante. El color puede formar parte de otro nivel de variación. Un GTIN identifica una unidad comercial específica. Una imagen puede pertenecer al modelo completo, a un color o, en determinados casos, a una variante concreta.
La herencia padre-variante permite que los datos comunes se mantengan una sola vez y que los productos hijos reciban esa información sin repetirla manualmente.
Conceptualmente suena simple. Operativamente cambia muchísimo.
Si tengo veinte variantes con la misma composición y necesito corregirla, quiero modificar el dato una vez, no veinte. Pero para que eso ocurra tengo que haber decidido correctamente qué atributos se heredan, cuáles varían y en qué nivel debe mantenerse cada uno.
El software puede ejecutar esa lógica. El criterio tiene que existir antes.
Talles: una talla M no siempre es solamente una M
Los talles merecen atención especial porque rápidamente dejan de ser una lista sencilla.
En uno de los proyectos de moda en los que trabajamos saneamos la información de más de 5.000 productos padre y más de 20.000 variantes, con talles numéricos y alfanuméricos conviviendo dentro del mismo ecosistema.
A primera vista, trabajar con XS, S, M, L o XL parece relativamente fácil. Hasta que aparecen talles 38, 40 y 42; equivalencias regionales; sistemas europeos y estadounidenses; talles únicos; combinaciones como XS/S y necesidades específicas de cada marca o canal.
En ese momento aparece una tentación bastante habitual: normalizar todo hasta que quede visualmente uniforme.
Yo prefiero otro enfoque.
Normalizar no significa borrar una diferencia que aporta información. Significa distinguir qué versión del dato necesita cada uso.
Puedo necesitar conservar un talle comercial utilizado por la marca y, al mismo tiempo, registrar un sistema de talles, una equivalencia regional o un valor normalizado que facilite filtros y comparaciones.
Si mezclamos esos conceptos en un único campo llamado “Talle”, la información termina obligándonos a elegir entre necesidades que no tendrían por qué competir.
Prefiero separar esas capas.
Por ejemplo:
| Tipo de dato | Ejemplo |
|---|---|
| Talle comercial | 40 |
| Sistema de talle | EU |
| Talle normalizado | M |
| Mercado | España |
| Equivalencia | US 8 |
No todos los negocios necesitan la misma cantidad de campos ni la misma profundidad de modelado. Ese es precisamente el punto: el modelo tiene que responder al negocio real, no a una plantilla universal.
Lo importante es hacerse esas preguntas antes de cargar decenas de miles de variantes. Después, cualquier cambio estructural cuesta mucho más.
Colores: preservar el lenguaje comercial sin romper los filtros
Con los colores ocurre algo parecido. “Azul” parece todavía más fácil.
Tampoco lo es.
Una colección puede utilizar denominaciones comerciales como Midnight, Ocean, Sky, Navy Blue o cualquier nombre definido por diseño y marketing. Esos nombres pueden formar parte de la identidad del producto y no tendría sentido eliminarlos solamente para que el catálogo quede más prolijo.
Pero tampoco quiero que el filtro de color del eCommerce muestre quince variantes de azul como si fueran quince familias cromáticas completamente independientes.
Por eso puedo conservar dos capas de información:
Color comercial: Ocean Blue
Color normalizado: Azul
El nombre comercial mantiene la expresión de la marca. El valor normalizado permite estructurar filtros, búsquedas, análisis y distribuciones hacia canales.
Ahí es donde los vocabularios controlados se vuelven una herramienta muy concreta. No se trata de imponer una única palabra en todos los contextos, sino de definir cuál representa cada concepto dentro de la capa estructurada del catálogo.
Normalizar no significa empobrecer el lenguaje del producto. Significa separar la expresión comercial del dato estructurado para poder conservar ambas.
Esta separación me parece especialmente importante en moda porque permite resolver una tensión recurrente: el lenguaje de una colección puede ser creativo; el dato que necesita procesar un sistema debe ser consistente. No tenemos por qué sacrificar uno para conseguir el otro.
En moda, una imagen también es un dato
En algunos sectores, una buena fotografía complementa una especificación técnica. En moda, la imagen suele ocupar un lugar mucho más central en la decisión de compra.
El comprador necesita entender cómo cae la prenda, cómo se percibe realmente el color, qué textura tiene, qué detalles incluye y cómo podría verse puesta. Eso convierte al activo visual en una parte integral de la información de producto.
Salsify señala entre la información que buscan los compradores de indumentaria online las imágenes, el detalle de talles y la composición o materiales.
Eso implica que las imágenes no deberían vivir como archivos sueltos que alguien “sube después”.
Necesitan relaciones y reglas.
- ¿Qué producto representan?
- ¿A qué color corresponden?
- ¿Cuál es la principal?
- ¿Cuáles son secundarias?
- ¿Hay una fotografía de detalle?
- ¿Hay una imagen lifestyle?
- ¿Puede publicarse en todos los canales?
- ¿Existe una versión diferente para un marketplace? ¿Está aprobada?
Tengo que saber a qué producto pertenece una imagen, qué color representa, cuál es la principal, cuáles son secundarias, qué fotografía muestra un detalle, cuál es lifestyle, si está aprobada y si puede distribuirse a todos los canales.
Cuando esta relación no se define, aparecen errores muy visibles: variantes con el color equivocado, imágenes antiguas que permanecen publicadas, fotografías faltantes o canales que reciben assets que no deberían recibir.
En otras palabras, la calidad visual del catálogo también depende de la calidad del modelo de datos que existe detrás.
Una fuente de verdad no significa una única ficha para todos los canales
Otro aprendizaje importante es que centralizar la información no significa publicar exactamente la misma representación del producto en todas partes.
Un eCommerce, un marketplace, un punto de venta, una plataforma de identificación mediante GTIN y un catálogo impreso pueden consumir información diferente y organizarla de maneras distintas.
En un proyecto real de CRITERIA para un grupo regional de moda multimarca tuvimos precisamente ese desafío. El modelo debía contemplar distintos destinos: ERP, eCommerce multitienda, punto de venta, generación de códigos GTIN, una plataforma para publicar en marketplace y un catálogo impreso.
El objetivo no fue obligar a todos esos sistemas a hablar igual. Fue construir un maestro de producto centralizado, saneado y mantenible desde el cual pudiera generarse la información necesaria para cada salida.
Centralizar no significa que todos los canales deban hablar igual. Significa tener una fuente controlada desde la cual construir la representación que cada canal necesita.
Un marketplace puede exigir su propia taxonomía y determinados atributos obligatorios. El eCommerce puede necesitar nombres comerciales, filtros y contenido enriquecido. El POS consume otra selección de datos. El catálogo impreso tiene necesidades editoriales particulares.
Mantener manualmente una versión independiente del mismo producto para cada uno de esos destinos genera duplicación y aumenta las posibilidades de inconsistencia.
La alternativa es modelar una vez y mapear varias veces.
Y para que eso funcione, la arquitectura conceptual del catálogo no puede depender exclusivamente del menú actual de un sitio web o de la estructura que exige un marketplace determinado.
¿Cuándo una colección está realmente lista para publicar?
Otro problema frecuente es confundir producto cargado con producto listo.
Que un SKU exista dentro del PIM solamente significa que existe. Puede faltarle la fotografía principal, la composición, una descripción, la categorización correcta, un talle normalizado o algún atributo obligatorio para determinado marketplace.
Por eso prefiero no preguntar solamente si un producto está completo.
La pregunta más útil es: ¿está completo para qué?
Un producto puede estar listo para el POS y no para el eCommerce. Puede cumplir todos los requisitos del sitio propio y todavía no estar preparado para un marketplace. Puede tener todos los atributos técnicos cargados, pero seguir esperando imágenes necesarias para una campaña.
En moda, donde las fechas de lanzamiento importan, esa diferencia es decisiva.
La velocidad no se consigue eliminando controles para publicar antes. Se consigue definiendo qué controles son realmente necesarios y permitiendo que el sistema haga visibles los faltantes antes de llegar a la fecha de lanzamiento.
Mi checklist antes de liberar una colección
Con el tiempo, buena parte de mi revisión terminó concentrándose en algunas preguntas muy concretas:
- ¿Los productos están relacionados correctamente con sus variantes?
- ¿Los vocabularios críticos —como color, talle, material o temporada— siguen criterios consistentes?
- ¿Cada variante tiene los identificadores que necesita?
- ¿Los activos están asociados al producto o color correcto y tienen un uso definido?
- ¿Sabemos qué información exige cada canal antes de intentar publicar?
- ¿Existe un criterio objetivo para determinar cuándo un producto está listo?
- ¿Podemos retirar una colección anterior sin eliminar información que todavía necesitamos conservar?
- ¿La próxima colección puede ingresar sin obligarnos a rehacer el modelo?
Para mí, la última pregunta es especialmente importante.
Un modelo de datos no es bueno solamente porque resuelva bien la colección que tengo delante. Es bueno cuando también puede absorber razonablemente aquello que todavía no llegó.
La mejor prueba de un modelo de moda no es comprobar si soporta la colección actual, sino preguntarse qué habría que cambiar cuando llegue la próxima.
Ordenar el catálogo para poder cambiar más rápido
A mí me gustan los sistemas, los patrones y encontrar la lógica que permite repetir una tarea sin reinventarla cada vez.
Pero sistematizar no debería significar volver rígido algo que por naturaleza cambia.
Y la moda cambia muchísimo.
Cambian las colecciones, los nombres comerciales, los colores, los canales y los mercados. Aparecen nuevos modelos, nuevas combinaciones de variantes y nuevas necesidades de publicación.
Por eso ocurre algo que, a primera vista, puede parecer contradictorio: cuanto más dinámico es el negocio, más importante resulta tener una estructura estable por debajo.
No para impedir el cambio.
Para absorberlo.
Cuando el catálogo está bien modelado, incorporar una nueva colección debería significar cargar, enriquecer, validar y publicar productos dentro de un proceso conocido. No volver a decidir desde cero cómo nombramos los colores. No reconstruir las matrices de talles. No repetir veinte veces una composición. No buscar fotografías en carpetas para descubrir a qué SKU pertenecen. No crear otra planilla porque el sistema dejó de representar lo que realmente está ocurriendo.
Un PIM puede ayudarnos a centralizar, heredar, validar y distribuir información. Pero ninguna herramienta reemplaza las decisiones que vienen antes: qué significa cada dato, dónde debe vivir, quién lo mantiene y para qué lo necesitamos.
Gestionar tres colecciones activas sigue siendo mucho trabajo incluso cuando el catálogo está bien diseñado. La diferencia es que deja de ser un trabajo basado en excepciones, memoria y urgencias permanentes. Y en una industria donde la próxima temporada siempre llega antes de lo que parece, tener una estructura capaz de acompañar ese movimiento es lo que permite que el catálogo cambie sin romperse.