Integración PIM: cómo elegir entre conectores, iPaaS y APIs sin subestimar el proyecto
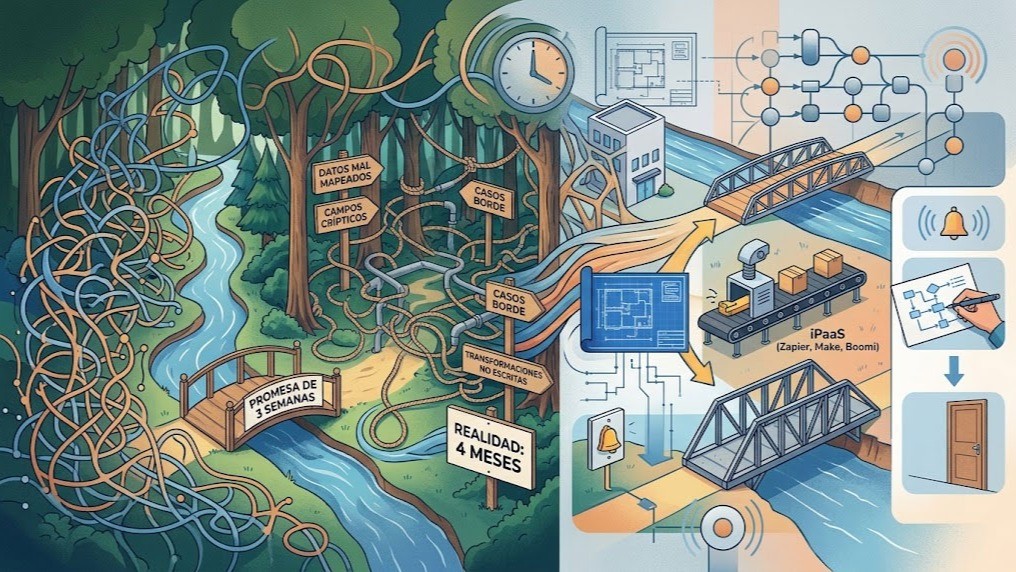
Las integraciones son uno de los componentes donde más fácilmente un proyecto PIM puede atrasarse, encarecerse o acumular deuda técnica. Y la causa rara vez está solamente en la tecnología elegida: suele aparecer cuando esa tecnología se decide antes de mapear los flujos o cuando se estima el esfuerzo sin conocer las transformaciones que requiere cada conexión.
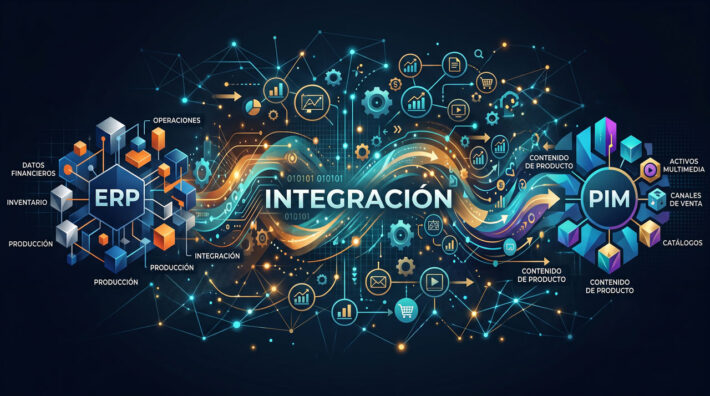
Integrar un PIM con un ERP, un eCommerce, un DAM o un marketplace no consiste simplemente en hacer que dos sistemas “se hablen”. Hay que decidir qué datos viajan, quién es responsable de cada dato, en qué dirección se mueven, qué transformaciones necesitan, con qué frecuencia deben actualizarse y qué ocurre cuando algo falla.
A partir de ese mapa se puede elegir la tecnología.
En términos generales, existen tres vías: conectores nativos, plataformas iPaaS e integración directa mediante API. A eso se suma otra decisión importante: determinar cuándo conviene sincronizar periódicamente los datos mediante polling y cuándo reaccionar a eventos mediante webhooks.
¿Qué opciones existen para integrar un PIM con el resto del ecosistema?
Para conectar un PIM con el ERP, el eCommerce, los marketplaces o el DAM existen tres vías principales, cada una con costos, plazos, flexibilidad y límites diferentes.
1. Conectores nativos
Son integraciones prefabricadas que el vendor del PIM —o el de la plataforma de destino— desarrolla y mantiene para combinaciones frecuentes, como PIM-Shopify, PIM-VTEX o PIM-Magento.
Cuando existen para el par de sistemas necesario y cubren realmente los flujos del proyecto, suelen ser la alternativa de menor complejidad. Buena parte de la implementación consiste en configuración, parametrización y mapping, en lugar de desarrollar toda la integración desde cero.
Su límite es la rigidez: el conector resuelve aquello para lo que fue diseñado. Si el negocio requiere transformaciones, entidades o reglas que quedan fuera de ese alcance, hay que extenderlo o buscar otra alternativa.
Por eso, comprobar que “existe un conector” no alcanza. Hay que verificar qué entidades sincroniza, en qué dirección, con qué frecuencia y qué posibilidades de transformación ofrece.
2. Plataformas iPaaS
Las plataformas Integration Platform as a Service (iPaaS) permiten conectar aplicaciones y construir flujos mediante componentes y configuraciones reutilizables. Zapier, Make y Boomi son ejemplos, aunque están orientados a escalas y necesidades muy diferentes.
Estas plataformas pueden resolver muy bien flujos simples y medianos, acelerar pruebas de concepto y reducir la cantidad de desarrollo específico.
Sus límites aparecen cuando crecen el volumen y la complejidad. Miles de productos, numerosas transformaciones, reglas de negocio sofisticadas o grandes cantidades de operaciones pueden incrementar costos, dificultar el mantenimiento o superar las capacidades prácticas de la plataforma elegida.
3. Integración directa mediante API
La tercera vía es desarrollar una integración específica contra las APIs de los sistemas involucrados.
Es la alternativa de mayor flexibilidad: permite controlar transformaciones, lógica de negocio, validaciones, observabilidad y manejo de errores. Pero esa flexibilidad tiene un costo. Requiere desarrollo, documentación, pruebas y mantenimiento ante cambios en las APIs o en los sistemas conectados.
Tiene sentido cuando el flujo es crítico, complejo o específico del negocio y las alternativas anteriores no cubren los requisitos.
La regla práctica es elegir la solución más simple que cubra correctamente el flujo: primero evaluar el conector nativo; después, una capa iPaaS o middleware; y recurrir al desarrollo específico cuando la complejidad realmente lo justifique.
Comenzar directamente por un desarrollo a medida puede significar asumir desde el primer día el costo y el mantenimiento más altos para resolver un problema que quizás admitía una solución más sencilla.
REST, polling y webhooks: ¿cuándo usar cada mecanismo?
Aquí conviene hacer una distinción técnica. REST y webhook no son exactamente conceptos opuestos. REST es un estilo utilizado para diseñar APIs; polling y webhooks describen dos formas diferentes de sincronizar cambios entre sistemas.
En un esquema de polling, el sistema que necesita información consulta periódicamente una API para averiguar si existen novedades. Es sencillo y suficiente cuando el dato tolera cierta latencia, pero puede generar consultas aunque nada haya cambiado.
Con webhooks, el sistema donde ocurre el evento envía una notificación cuando se produce el cambio. Esto reduce consultas innecesarias y permite reaccionar con mucha menor latencia, aunque exige gestionar correctamente reintentos, duplicados, autenticación, fallos de entrega y reconciliación.
La elección depende principalmente de la naturaleza y criticidad del flujo.
El dato relativamente estable —por ejemplo, descripciones, atributos comerciales o determinada información editorial— puede admitir sincronizaciones programadas. En cambio, los datos o eventos que requieren reacción rápida necesitan mecanismos de menor latencia.
En la práctica, una arquitectura puede combinar ambos patrones: sincronizaciones programadas para determinados datos de producto y mecanismos basados en eventos para aquellos cambios que requieren propagación rápida.
No hay que convertir esta regla en dogma. La decisión también depende de las APIs disponibles, el volumen, los SLA y la tolerancia del negocio a trabajar temporalmente con información desactualizada.
¿Por qué se subestima tanto el esfuerzo de las integraciones PIM?
Porque concentran buena parte del trabajo que no aparece en una demo.
Una integración no es solamente el “caño” que une dos sistemas. Es, sobre todo, la traducción entre modelos de datos que casi nunca coinciden completamente.
Hay campos del sistema origen con nomenclaturas históricas que deben interpretarse. Transformaciones que el negocio considera obvias y nunca documentó: unidades, formatos, concatenaciones, equivalencias y reglas condicionales.
Después aparecen los datos reales: productos sin código, variantes huérfanas, valores fuera del vocabulario permitido, relaciones inexistentes o atributos cargados de maneras diferentes.
Y todavía falta definir qué sucede cuando algo falla: reintentos, alertas, colas, logs y procesos de reconciliación.
Por eso, cuando una propuesta presenta las integraciones como un renglón menor sin detallar estos componentes, no necesariamente significa que las conexiones sean sencillas. Puede significar que todavía no fueron relevadas con suficiente profundidad.
Los 6 errores más frecuentes al estimar una integración PIM
1. Estimar antes de mapear
Una estimación realizada sin saber qué dato viaja, de dónde a dónde, qué transformación requiere y con qué frecuencia debe sincronizarse tiene una base demasiado débil.
El mapa de flujos es el prerrequisito de una estimación defendible.
2. Suponer que el conector nativo cubre todo
Un conector suele resolver casos previstos por su fabricante. Los procesos específicos del negocio requieren validar su alcance antes de comprometer plazos.
3. Ignorar la calidad de los datos de origen
La integración puede probarse con datos controlados y después encontrarse con datos reales muy diferentes. Sanear esos registros —o gestionar aquellos que no pueden sanearse automáticamente— forma parte del proyecto.
4. No presupuestar el manejo de errores
Construir el flujo exitoso es solo una parte del trabajo. También hay que decidir qué ocurre cuando el destino no responde, el dato es inválido o una cola de procesamiento se acumula.
Eso es lo que diferencia una integración preparada para producción de una demostración que solamente funciona cuando todo sale bien.
5. Olvidar el mantenimiento
Las APIs evolucionan, los marketplaces cambian esquemas y los sistemas incorporan nuevas versiones. Toda integración necesita un responsable, documentación y capacidad de mantenimiento.
Una integración sin dueño termina convirtiéndose en deuda técnica.
6. Elegir tecnología por preferencia y no por necesidad
Un equipo acostumbrado a desarrollar puede intentar desarrollar cada conexión. Otro puede forzar una herramienta low-code más allá de sus límites.
La arquitectura correcta no tiene por qué utilizar una única tecnología. Cada tramo debe resolverse con la alternativa que mejor corresponda a sus requisitos.
¿Cómo diseñar la arquitectura de integración antes de conectar?
Antes de desarrollar, conviene recorrer seis pasos.
1. Inventariar las conexiones
Listar cada sistema y cada flujo: qué sale del ERP hacia el PIM, qué publica el PIM hacia los canales, qué assets llegan desde el DAM y qué información debe regresar.
2. Definir frecuencia y latencia
Determinar qué flujos pueden ser diarios u horarios y cuáles necesitan propagarse casi inmediatamente.
Esta decisión ayuda a elegir entre sincronizaciones programadas y mecanismos basados en eventos.
3. Documentar las transformaciones
Campo por campo: qué se mapea contra qué, qué conversión necesita, qué valores son válidos y qué regla debe aplicarse.
Es un trabajo poco vistoso, pero es el que transforma una estimación intuitiva en una estimación defendible.
4. Elegir la vía para cada conexión
Con el mapa completo, evaluar conector nativo → iPaaS/middleware → desarrollo directo, buscando siempre la alternativa más simple que satisfaga los requisitos reales.
5. Diseñar el manejo de fallas
Definir reintentos, alertas, logs, colas y procedimientos de reconciliación antes de salir a producción, no durante el primer incidente.
6. Asignar la propiedad del mantenimiento
Cada integración necesita un responsable —interno o externo— y un criterio claro para gestionar cambios y evoluciones.
Primero el flujo, después la tecnología
Integrar un PIM no es tomar una única decisión tecnológica. Es tomar una serie de decisiones para cada conexión del ecosistema.
Puede haber un conector nativo donde exista y sea suficiente, un iPaaS o middleware donde el flujo lo permita y un desarrollo directo donde la complejidad lo justifique. Del mismo modo, algunos datos podrán sincronizarse periódicamente y otros necesitarán mecanismos basados en eventos.
Pero ninguna de esas decisiones debería tomarse antes de realizar el trabajo que los proyectos apurados suelen saltearse: mapear sistemas, propietarios del dato, flujos, transformaciones, frecuencias, excepciones y mecanismos de recuperación.
Ahí está buena parte de la complejidad real de una integración PIM.
Tratar las integraciones como un renglón menor del presupuesto no las hace más baratas. Solo posterga el momento en que el proyecto descubre su costo verdadero, generalmente cuando el cronograma ya está comprometido.
Por eso, antes de pedir un presupuesto de desarrollo, conviene hacer otra cosa: dibujar el mapa completo del ecosistema y entender qué necesita realmente cada conexión. Recién entonces tiene sentido elegir la tecnología y estimar cuánto costará construirla.