Skip to content
  • Servicios
    • Limpieza de datos
    • Implementaciones PIM
    • Integraciones
  • Casos
  • CRITERIA Framework
  • FAQ
  • Elige tu PIM
  • Blog
  • Contacto

Arquitectura del Dato

  • Home
  • Blog
  • Arquitectura del Dato
  • Page 2
Arquitectura del Dato, Catalogación, Vocabulario

Tipos de atributos en un PIM: cuándo usar texto libre, cuándo una lista y cuándo un número

26/08/2026 Aimé Enrique Comentarios desactivados en Tipos de atributos en un PIM: cuándo usar texto libre, cuándo una lista y cuándo un número

Una guía práctica para decidir qué tipo de atributo usar en cada caso: las reglas simples que evitan los errores de diseño más comunes en un catálogo.
Arquitectura del Dato, Calidad de Datos, Catalogación

Errores en el diseño de atributos que encuentro en el 80% de los proyectos (y cómo los corrijo)

25/08/2026 Belén Rivero Comentarios desactivados en Errores en el diseño de atributos que encuentro en el 80% de los proyectos (y cómo los corrijo)

Cuando un catálogo tiene atributos duplicados, tipologías mal elegidas o valores sin normalizar, el problema no se queda en la carga de datos: empieza a afectar búsqueda, filtros, integraciones, escalabilidad y calidad general del modelo. En mi trabajo, corregir atributos no es “ordenar campos”: es reconstruir la lógica con la que el catálogo describe sus productos.
Arquitectura del Dato, Calidad de Datos, Integraciones

Normalización de datos como paso previo a la integración: cómo estandarizar antes de enviar

20/08/2026 Erwin Marte Comentarios desactivados en Normalización de datos como paso previo a la integración: cómo estandarizar antes de enviar

Antes de conectar un sistema externo al PIM, los datos tienen que pasar por una etapa de normalización. No alcanza con que “estén cargados”: tienen que estar estandarizados, consistentes y listos para viajar sin romperse en el camino. En esta nota, Erwin baja a tierra los patrones de transformación que suele aplicar para alinear vocabulario, formatos y valores antes de integrar.
Arquitectura del Dato, Calidad de Datos, Vocabulario

Vocabulario controlado: por qué la consistencia semántica es el trabajo invisible que sostiene todo

18/08/2026 Belén Rivero Comentarios desactivados en Vocabulario controlado: por qué la consistencia semántica es el trabajo invisible que sostiene todo

Cuando dos productos del mismo tipo quedan descritos con palabras distintas, el problema no es solo estético: empieza a romperse la lógica del catálogo. En mi trabajo, construir vocabularios controlados es una forma de sostener consistencia, búsqueda, escalabilidad y calidad de datos sin depender de la memoria ni del criterio cambiante de cada persona.

Arquitectura del Dato, Catalogación, Integraciones, Vocabulario

Taxonomías en APIs: cómo modelar y exponer jerarquías de categorías para múltiples canales

13/08/2026 Erwin Marte Comentarios desactivados en Taxonomías en APIs: cómo modelar y exponer jerarquías de categorías para múltiples canales

La taxonomía que vive en el PIM no genera valor completo si queda encerrada dentro del sistema. Para que realmente ordene el ecosistema de producto, tiene que poder exponerse de forma útil a los sistemas que la consumen. La clave no es solo diseñar bien la jerarquía, sino publicarla por API con el nivel de flexibilidad, contexto y estabilidad que requiere cada canal.

Arquitectura del Dato, Catalogación, Vocabulario

¿Qué es una taxonomía de producto y por qué importa más de lo que parece?

12/08/2026 Aimé Enrique Comentarios desactivados en ¿Qué es una taxonomía de producto y por qué importa más de lo que parece?

Una explicación clara para equipos que nunca escucharon el término: qué es una taxonomía, para qué sirve y cómo afecta a la búsqueda, la navegación y el orden real de un catálogo de productos.

Arquitectura del Dato, Catalogación, Vocabulario

Cómo diseño una taxonomía de producto desde cero: mi proceso paso a paso

11/08/2026 Belén Rivero Comentarios desactivados en Cómo diseño una taxonomía de producto desde cero: mi proceso paso a paso

La taxonomía no se improvisa. Antes de crear categorías, hay que entender qué vende la empresa, cómo nombra sus productos, cómo los busca el usuario y qué estructura va a poder sostener el equipo en el día a día. Belén recorre su proceso completo: desde el relevamiento inicial hasta la validación con quienes van a usar esa taxonomía todos los días.
Arquitectura del Dato, Calidad de Datos, Vocabulario

Variantes, matrices y configurables: la parte del catálogo donde todo se complica

01/08/2026 Marcelo Cutini Comentarios desactivados en Variantes, matrices y configurables: la parte del catálogo donde todo se complica

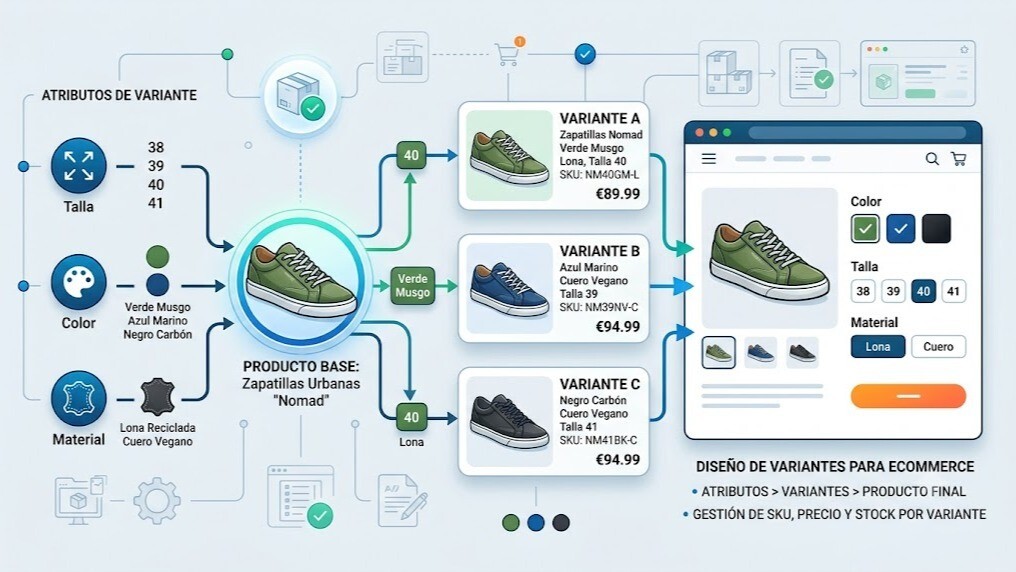
Las variantes son donde la mayoría de los modelos de datos bien diseñados se rompen. Un producto que existe en cinco colores y seis tallas no son treinta productos independientes: es un producto con una estructura de variación que hay que modelar correctamente, o el catálogo se convierte en un caos de duplicados, inconsistencias y fichas que no se entienden. Este artículo explica cómo modelar variantes, matrices y configurables sin romper la relación padre-hijo — con las diferencias que cada industria impone.

Arquitectura del Dato, Integraciones, Plataformas PIM

inriver y su arquitectura de integración: ¿cómo conectan iPMC, APIs y framework el dato de producto con cada canal?

30/07/2026 Erwin Marte Comentarios desactivados en inriver y su arquitectura de integración: ¿cómo conectan iPMC, APIs y framework el dato de producto con cada canal?

inriver no se entiende bien si se lo mira solo como un PIM enterprise orientado al almacenamiento. Su diferencia aparece con más claridad cuando se analiza cómo prepara, transforma y entrega el dato hacia canales, adaptadores y experiencias de producto. Ahí es donde su arquitectura de integración gana peso técnico real.
Arquitectura del Dato, Fundamentos PIM, Vocabulario

Atributos de producto: cómo diseñar un modelo que no envejezca en seis meses

25/07/2026 Marcelo Cutini Comentarios desactivados en Atributos de producto: cómo diseñar un modelo que no envejezca en seis meses

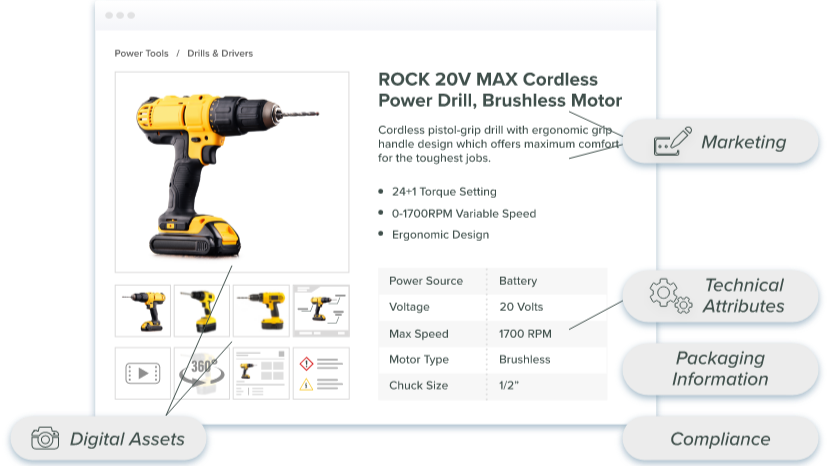
El modelo de atributos es donde vive la descripción real de cada producto — y donde la mayoría de los catálogos acumulan la deuda técnica que los vuelve inmanejables. El error no es no tener atributos: es diseñarlos mal, crear uno nuevo para cada excepción y terminar con un modelo de cientos de campos que nadie entiende ni mantiene. Este artículo explica cómo diseñar un modelo de atributos que soporte el crecimiento del catálogo sin envejecer ni convertirse en un pantano.

Paginación de entradas

Anteriores 1 2 3 … 5 Siguientes

Search

Categories

  • Arquitectura del Dato (44)
  • Calidad de Datos (27)
  • Casos de uso (8)
  • Catalogación (24)
  • Equipo y Operaciones (12)
  • Estrategia y Gobernanza (17)
  • Fundamentos PIM (46)
  • Integraciones (35)
  • Plataformas PIM (35)
  • Reviews y Comparativas (27)
  • SEO (2)
  • Tendencias (2)
  • Vocabulario (17)

Recent posts

  • Integración PIM-VTEX con Node.js: sincronización de catálogo, precios y stock en tiempo real
  • Cómo revisar que los datos del PIM llegaron bien al eCommerce: mi checklist de validación post-publicación
  • ¿Qué pasa con el catálogo cuando el eCommerce publica una versión vieja del dato?

Tags

Activos digitales API-first Arquitectura de datos bluestone BlueStone PIM Calidad de datos Catálogo digital cms Composable Commerce dam Data quality datos de producto eCommerce erp excel ficha de producto B2B ficha de producto ecommerce ficha de producto marketplace Gobernanza de datos Golden Record google sheets Headless Commerce Información de producto Integraciones kpi MACH mdm PDP ecommerce pim Reviews PIM sales layer seo syndication taxonomia

Quirúrgicamente especializados en la catalogación de productos

Servicios
  • PIM
  • Datos
  • Integraciones
  • Automatización
Contacto
1209 Mountain Road Place Northeast
Albuquerque, NM 87110, USA
[email protected]

© CRITERIA ONLINE LLC. All Rights Reserved.

  • Términos y condiciones
  • Política de privacidad